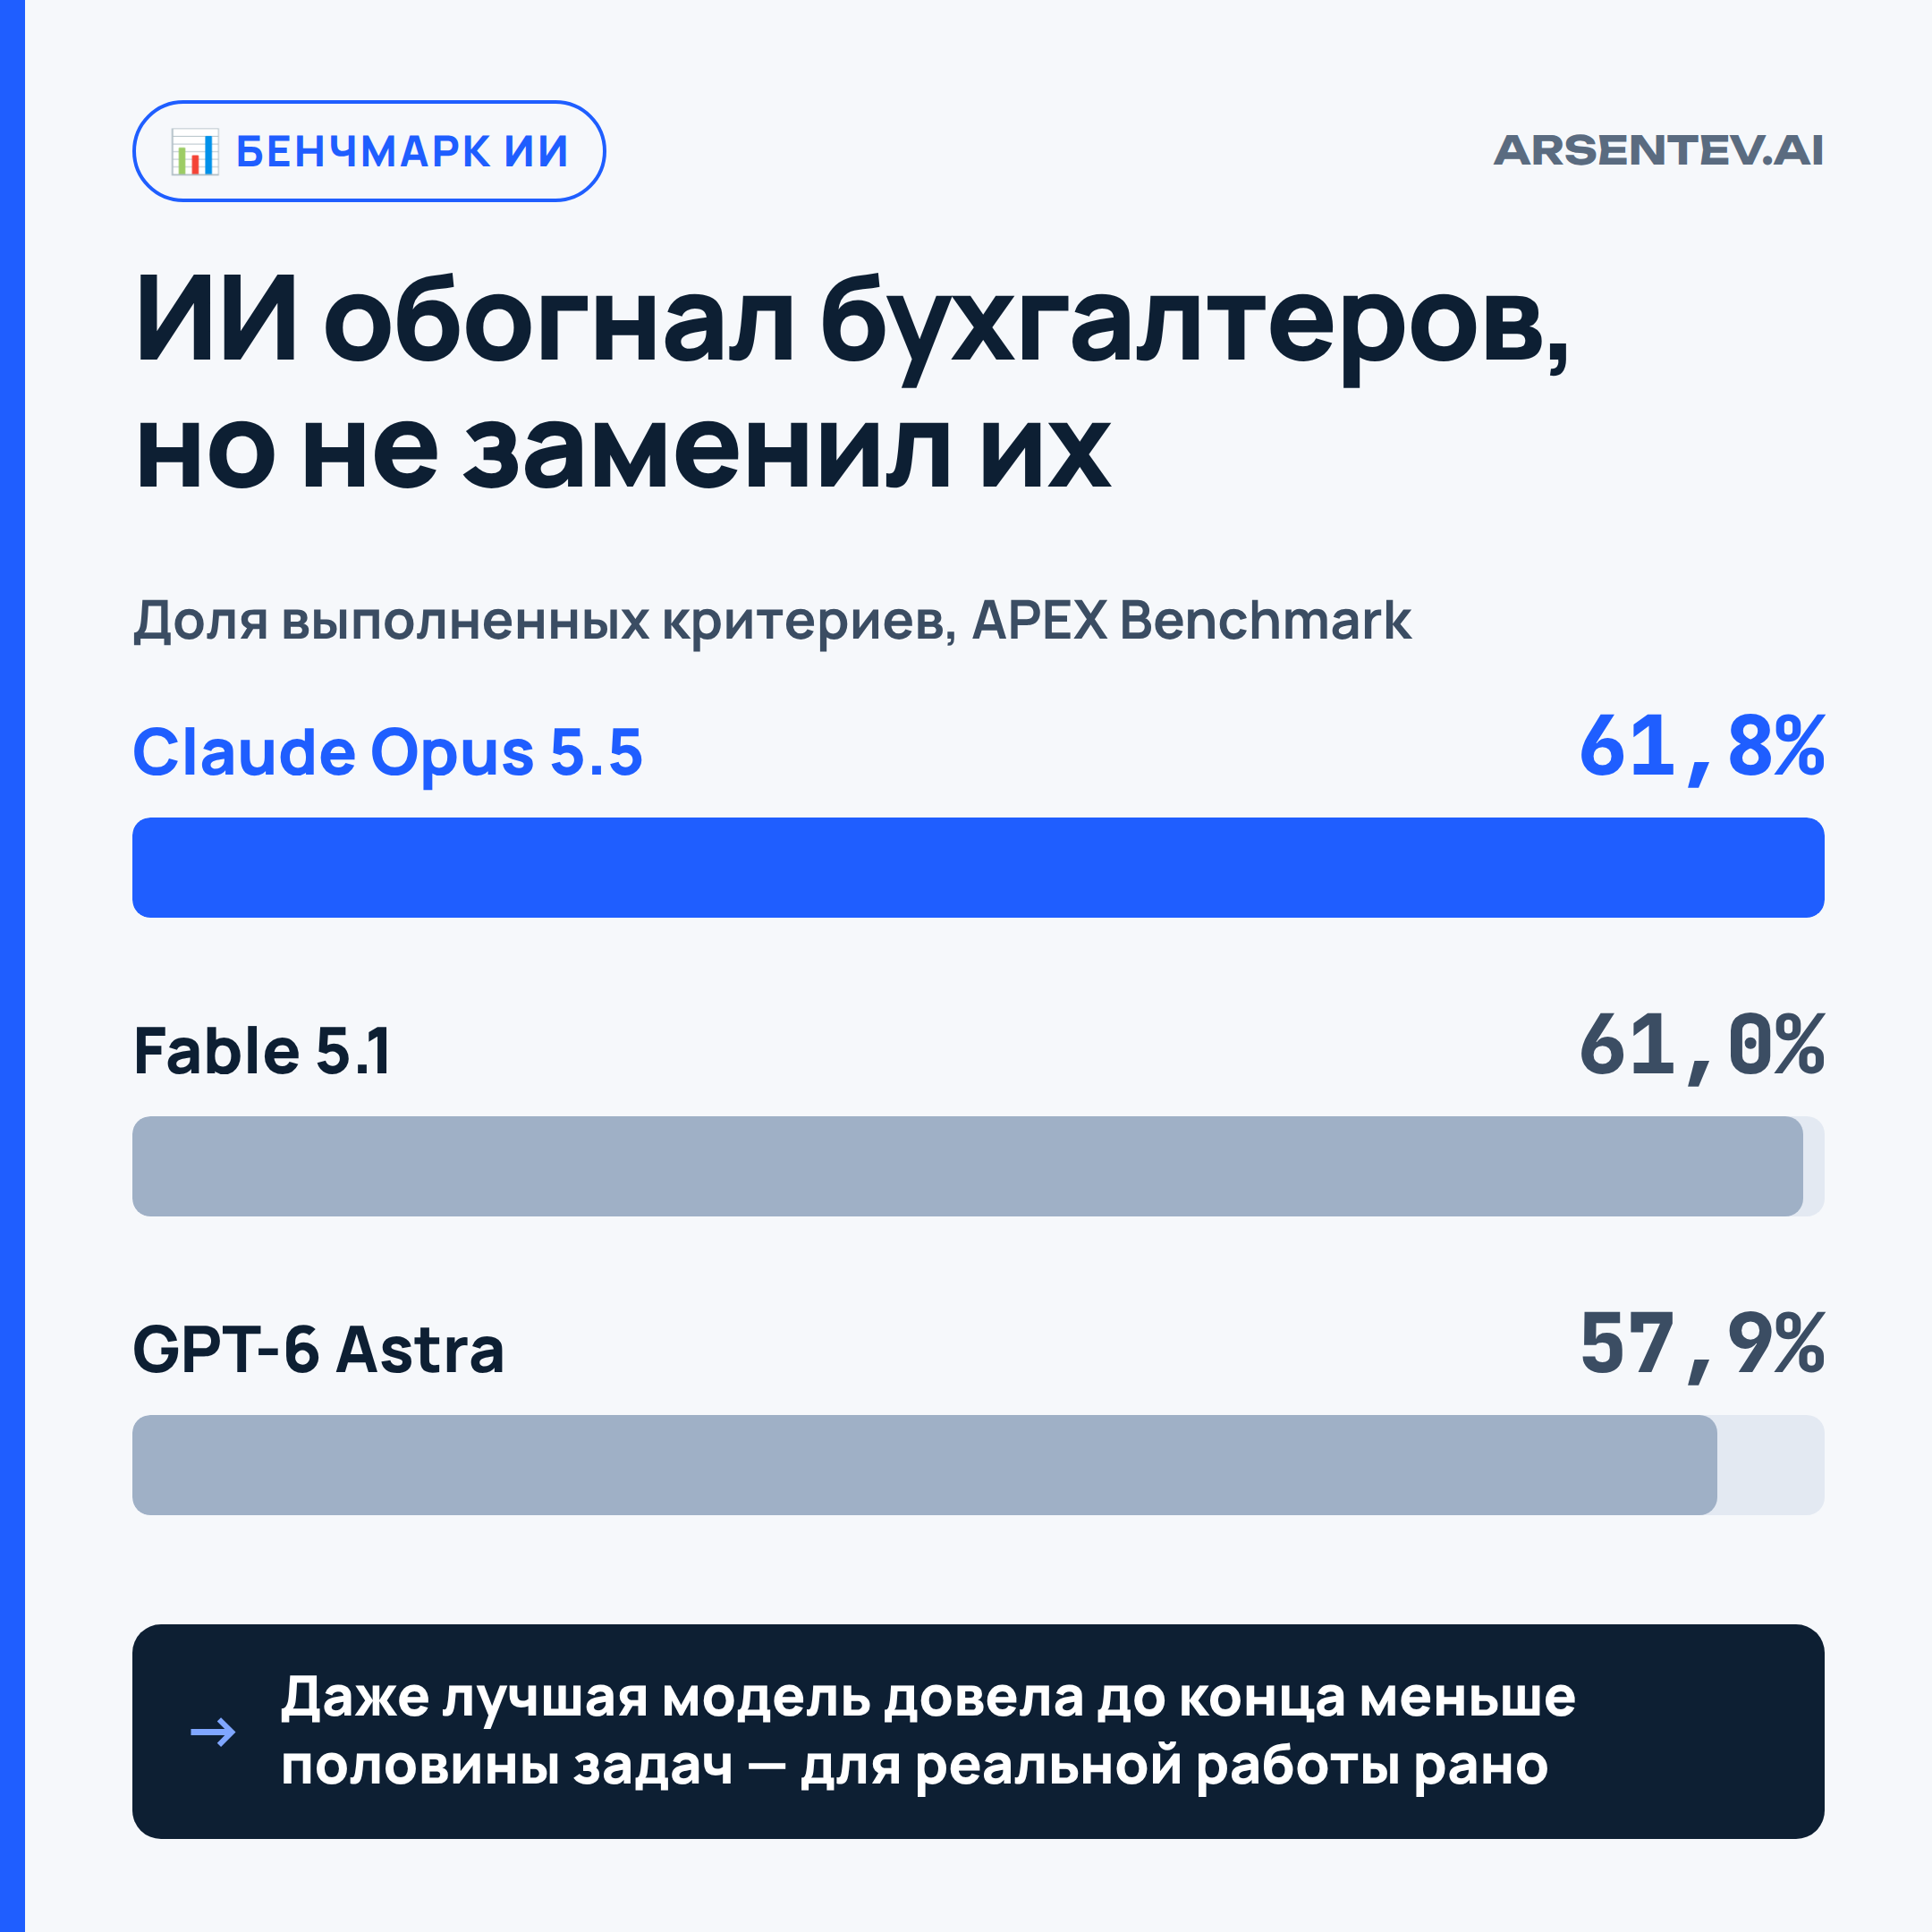
Искусственный интеллект превосходит бухгалтеров, но не заменит их.
Mercor протестировал AI-агентов на наборе бухгалтерских задач. Люди показали слабый результат (около 37%) на простых заданиях, тогда как AI-модели справились почти безупречно. Claude Opus 5.5 набрал наивысший балл по всему APEX Benchmark (61,8% выполненных критериев).
Интересно, что Mercor протестировал современных AI-агентов на наборе бухгалтерских задач, которые решали 12 сертифицированных специалистов со средним стажем 5,5 лет. В простом тесте люди ошибались почти постоянно. Их точность составила около 37%. При этом AI-модели решали те же задачи почти без ошибок. В полном APEX Benchmark, состоящем из 160 задач, разделённых между 10 разными компаниями, лучше всех показал себя Claude Opus 5.5, набрав 61,8% выполненных критериев. Однако даже Opus не довёл до конца почти 60% всех задач бенчмарка.
Это совпадает с тем, как я использую Claude Code. Opus 5 я использую ежедневно, Fable 5.1 — для сложных задач, а GPT-6 Astra, на мой взгляд, примерно на уровне Opus, но немного уступает Fable. В бенчмарке Astra набрал 57,9%, Opus — 61,8%, а Fable — 61,0%. Так что пока не стоит паниковать и увольнять бухгалтеров. В этом бенчмарке не учитывалось общение с клиентами и принятие решений на основе опыта — а это важнейшие части работы. Прежде чем применять любого агента на своих конфиденциальных данных, обязательно протестируйте его на выборке собственных счетов и проверьте ошибки вручную, а не полагайтесь на результаты этого бенчмарка.
Источник: the-decoder.com
Бесплатный курс
Хватит читать про ИИ — начни строить с ним
Бесплатный курс Claude Code: свой первый сайт, инструмент или игра — без программирования. Без апсейлов и кросс-сейлов — здесь нечего купить.
Начать →
Автор
Евгений Арсентьев
PhD · Founder & CEO, Dad4Kids
Статьи · Свежие статьи