GitHub-радар
Разбери запись по голосам: кто говорил и когда — без видеокарты
Это инструмент, который сам определяет, кто говорит и когда, в аудиозаписи с несколькими участниками — без расшифровки текста. После установки у тебя будет готовая временная шкала говорящих для подкаста или видео.
Программа слушает аудиофайл и отмечает, в какие моменты говорит каждый из участников. Распознавать слова и писать текст она не умеет — только показывает, кто и когда говорил.
Когда пригодится
Пригодится, если ты делаешь подкаст, видео или разбираешь созвон с несколькими людьми и хочешь быстро понять, кто и когда говорил. Если запись с одним голосом или нужен готовый текст разговора, эта модель не подойдёт.
Плюсы
- Работает на обычном компьютере, видеокарта не обязательна
- Можно использовать полностью офлайн, без интернета
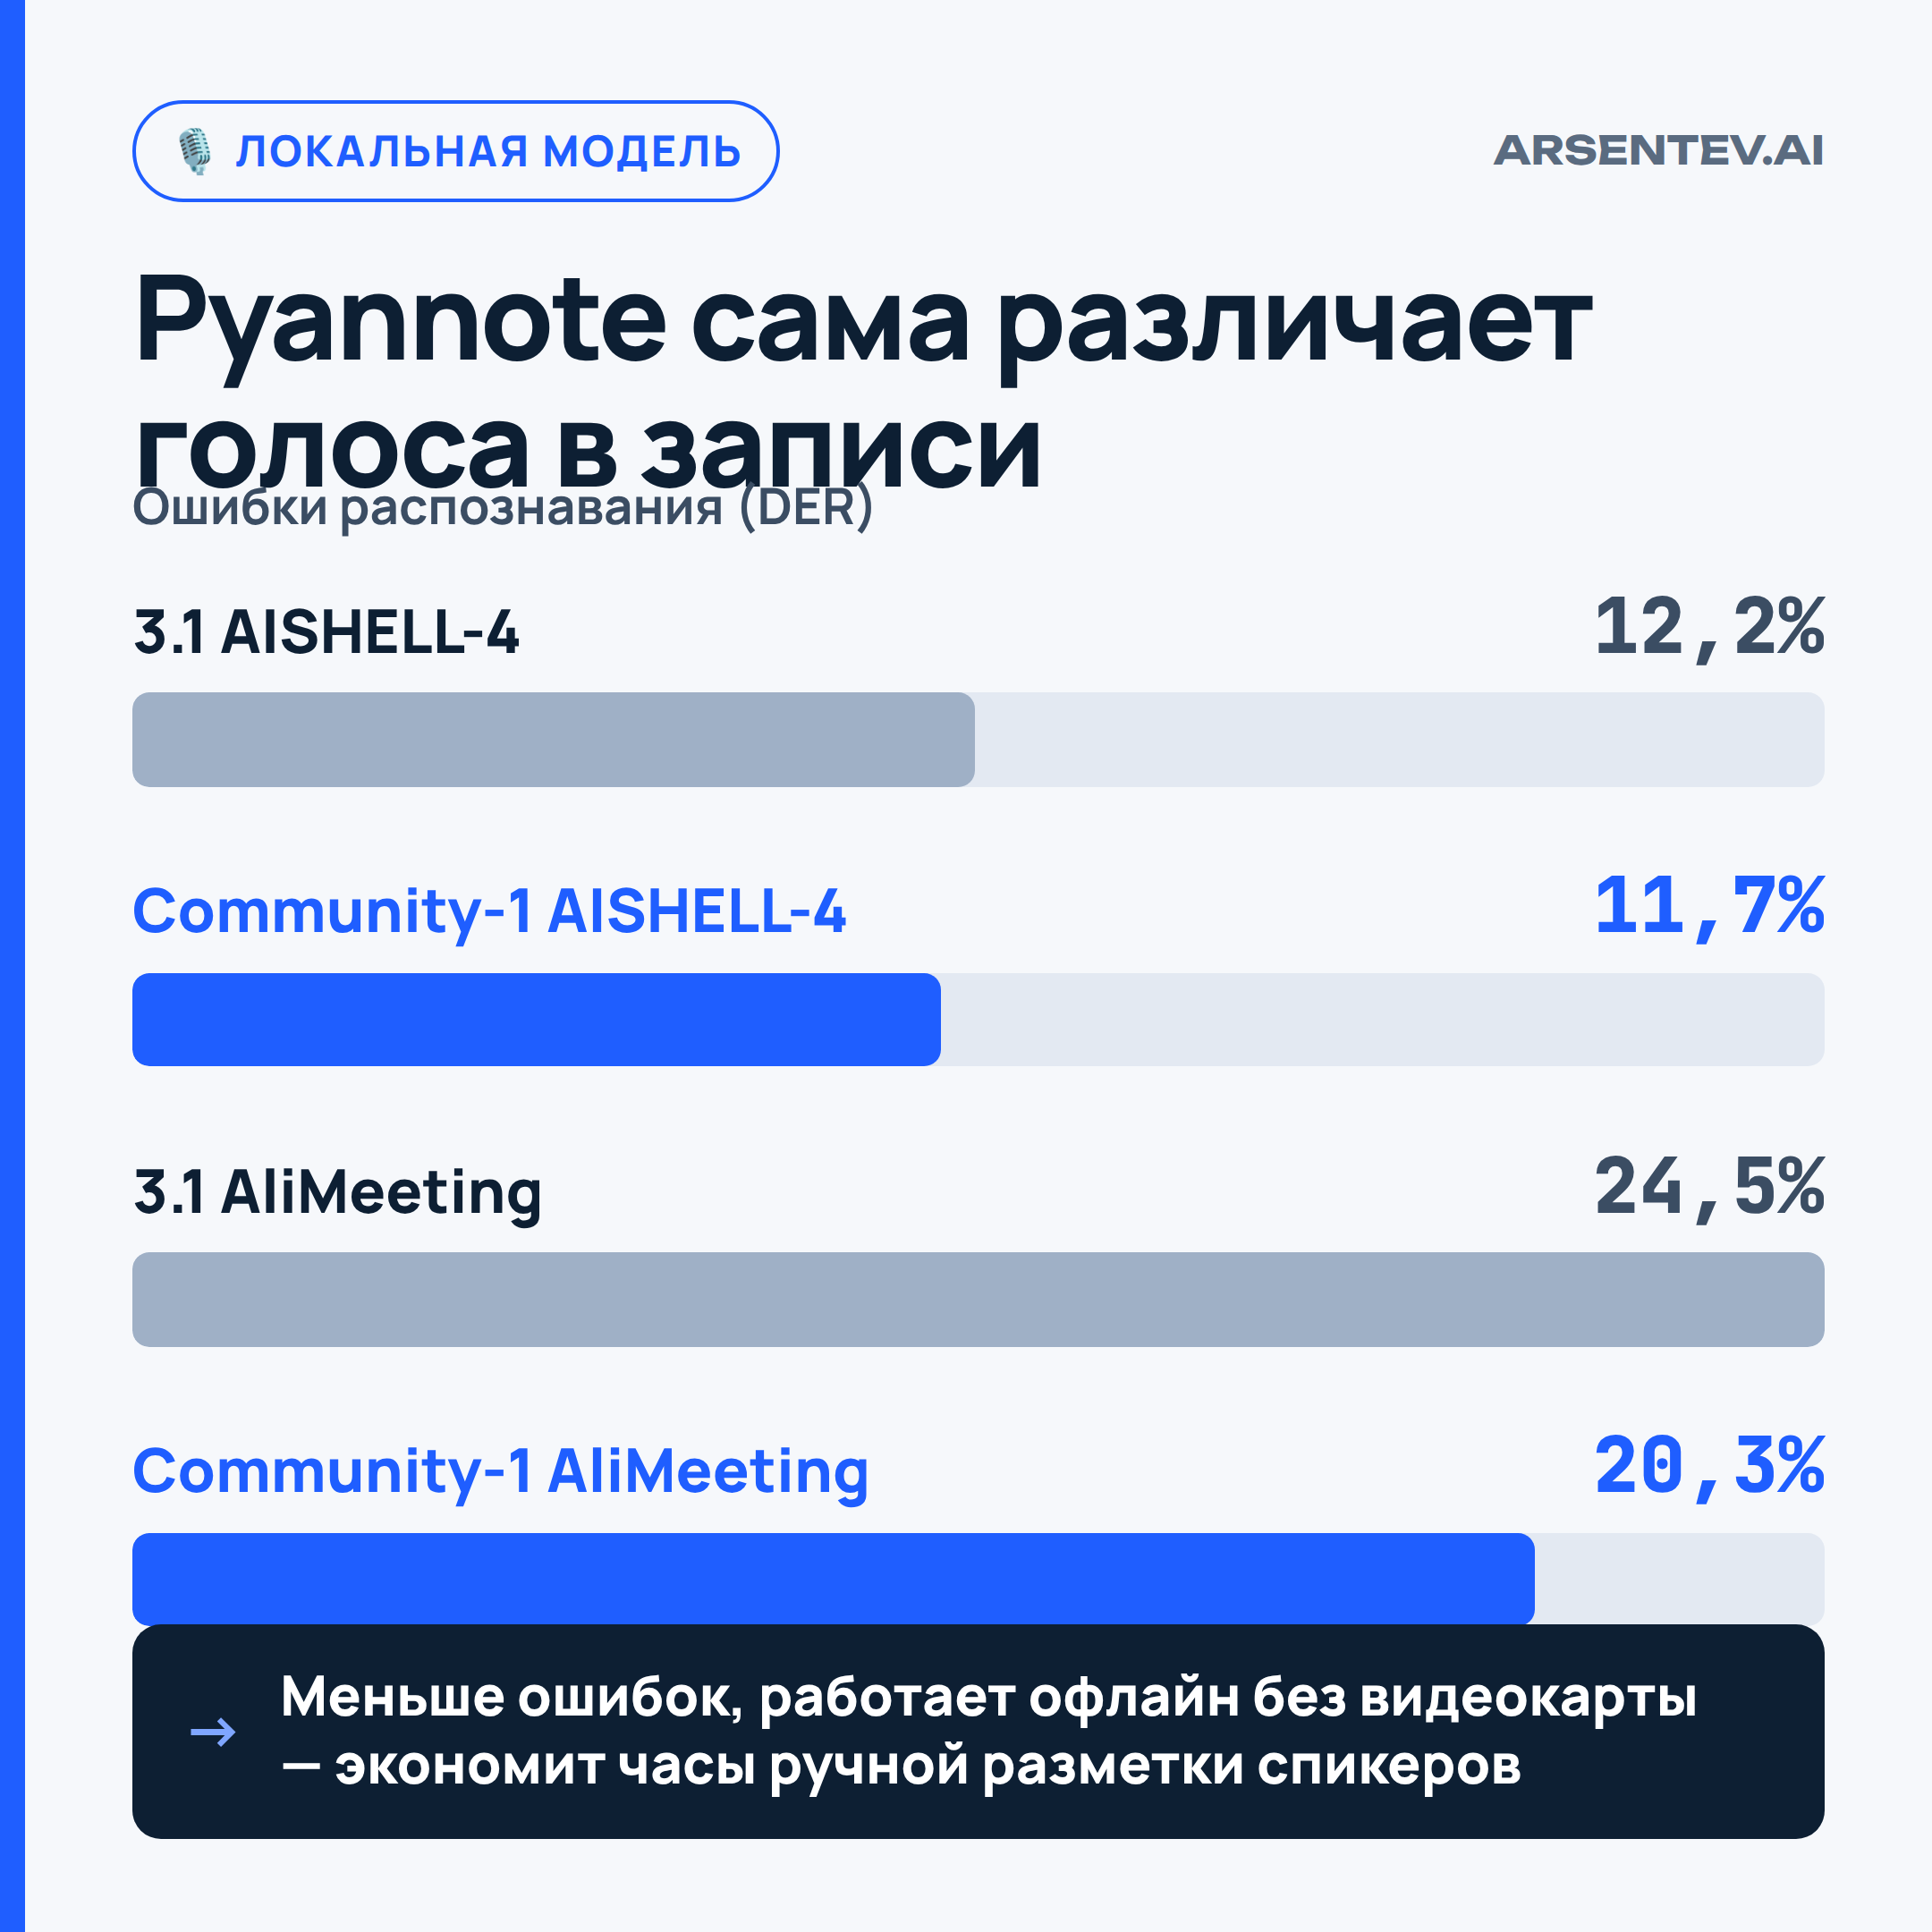
- Ошибок меньше, чем в прошлой версии модели
- Если знаешь число говорящих, можно подсказать это модели
Минусы
- Модель закрыта — нужно согласиться с условиями и получить токен Hugging Face
- Сама не распознаёт слова — только определяет говорящих
Как поставить — по шагам
- 1Открой ИИ-агента (Claude Code, Codex) в папке своего проекта
- 2Приготовь аудиофайл с несколькими говорящими, который хочешь разобрать
- 3Отправь агенту текст из блока ниже
- 4Дай агенту доступ к файлу — он заведёт токен Hugging Face и установит библиотеку pyannote.audio
- 5Проверь результат: агент должен показать, кто и когда говорил в записи
Текст для агента
Текст для шага с агентом — скопируй и отправь (Claude Code, Codex, любой):
Поставь мне у себя модель Pyannote для разбора записи по голосам: https://huggingface.co/pyannote/speaker-diarization-community-1 - заведи токен Hugging Face, установи pyannote.audio и обработай вот эту запись (дай файл), показав, кто и когда говорил.
Работает на обычном компьютере без видеокарты - считает на процессоре, видеокарта просто ускорит обработку. Нужен Python и библиотека pyannote.audio.
Открыть на Hugging Face▌ Ещё находки